

Вызванный потенциал, повторяющий частоту звукового стимула (Frequency Following Response, FFR) — это нейрофизиологический отклик на звук, который точно отражает текущую динамику звукового сигнала. Его можно использовать для изучения целостности и пластичности нейронного кодирования звука на протяжении всей жизни. Обработка звука в мозге может нарушаться при патологиях и улучшаться благодаря приобретённому опыту. FFR позволяет оценить последствия языковой депривации, аутизма, сотрясения мозга и нарушений чтения, а также отражает влияние обогащения опыта — например, краткосрочного обучения, билингвизма или занятий музыкой [3].
На базе оборудования и ПО МКС был создан прототип монитора FFR, на котором был создан и воспроизведен аудиостимул с заданными характеристиками и получен в ответ вызванный потенциал Frequency Following Response /FFR/, генерируемый, предположительно, в стволе мозга и регистрируемый на скальпе в локации Cz [проекция inferior colliculus, 2].
- При частоте дискретизации 10000 Гц временной джиттер не превышал 1 мс, утрата меток не превышала 0.0002 % от их общего числа
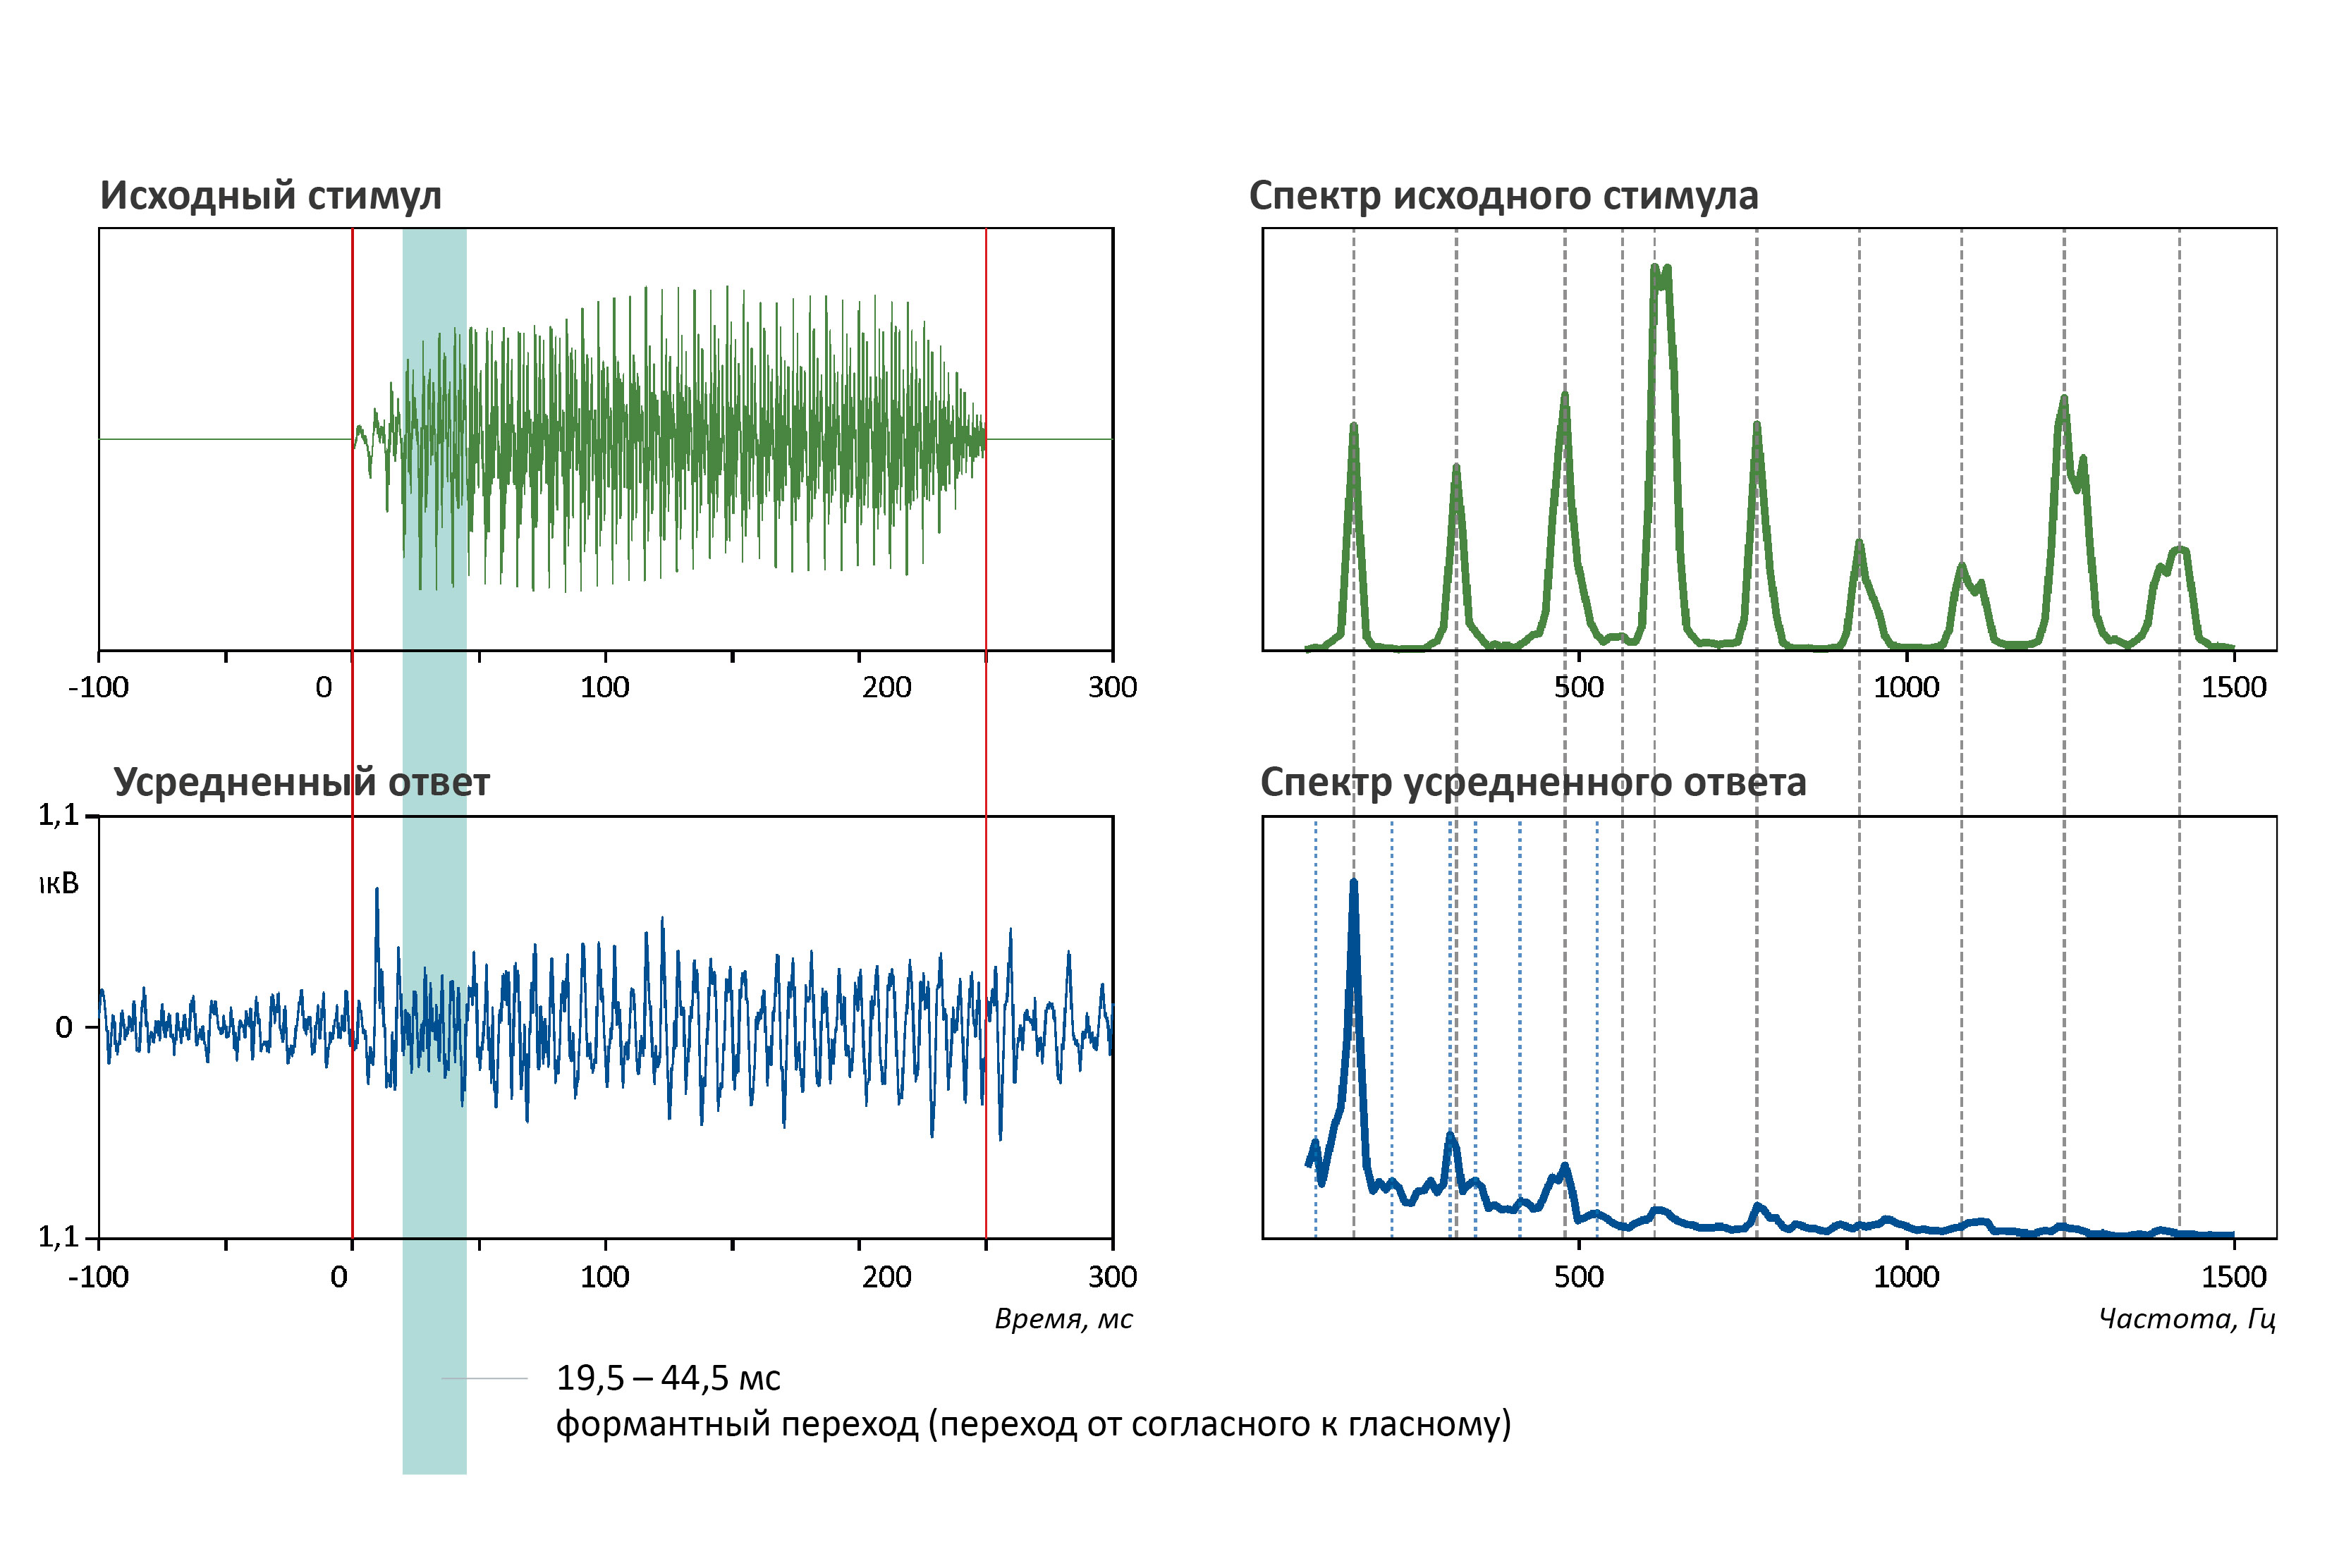
- Вызванный потенциал имеет амплитуду в ожидаемом диапазоне ±0.2 мкВ [3] и гармоники на частотном спектре с пиками спектральной амплитуды. До половины пиков совпадает со спектральным профилем аудиостимула [4]
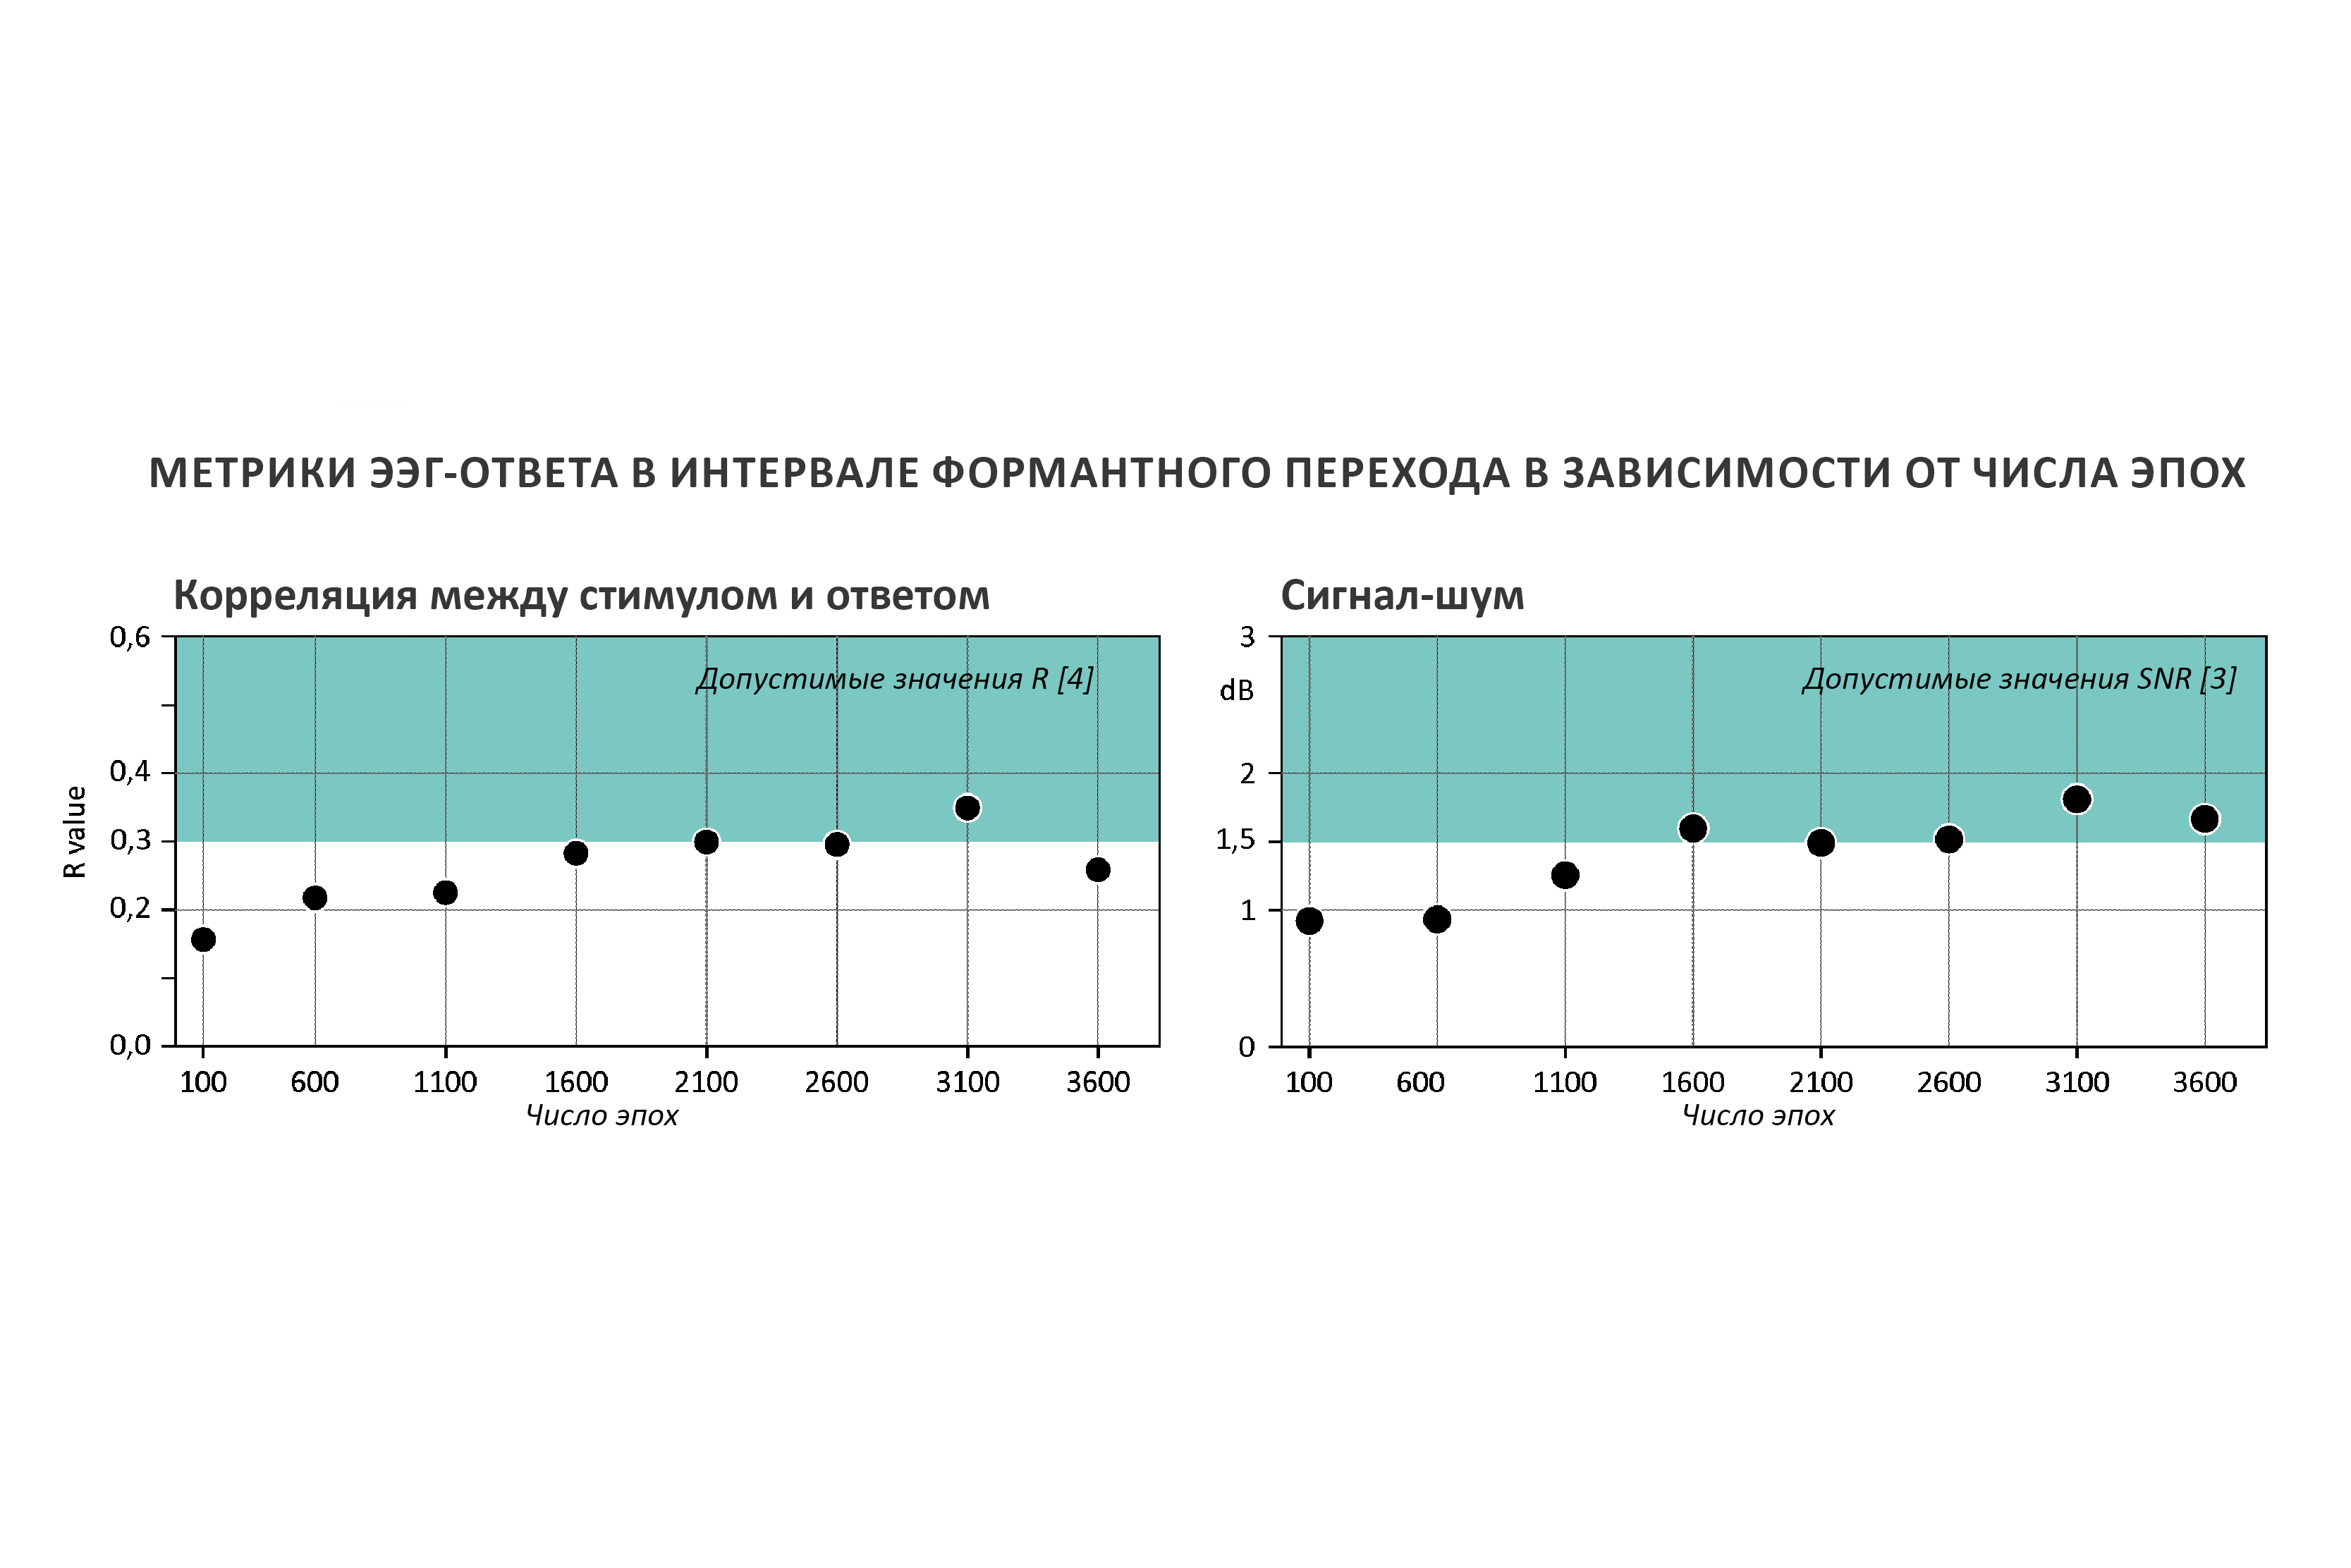
- Коэффициент корреляции между стимулом и вызванным потенциалом FFR с лагом в 7–9 мс (время на передачу сигнала от уха к структурам среднего мозга) в интервале формантного перехода 19.5–44.2 мс [3] увеличивается по мере увеличения числа усреднений и достигает публикуемых показателей r > 0.3 [4]
- Соотношение сигнал-шум (Signal to Noise Ratio) мс в интервале формантного перехода 19.5–44.2 мс растет (улучшается) по мере увеличения числа усреднений и достигает публикуемых показателей [4].
Оборудование
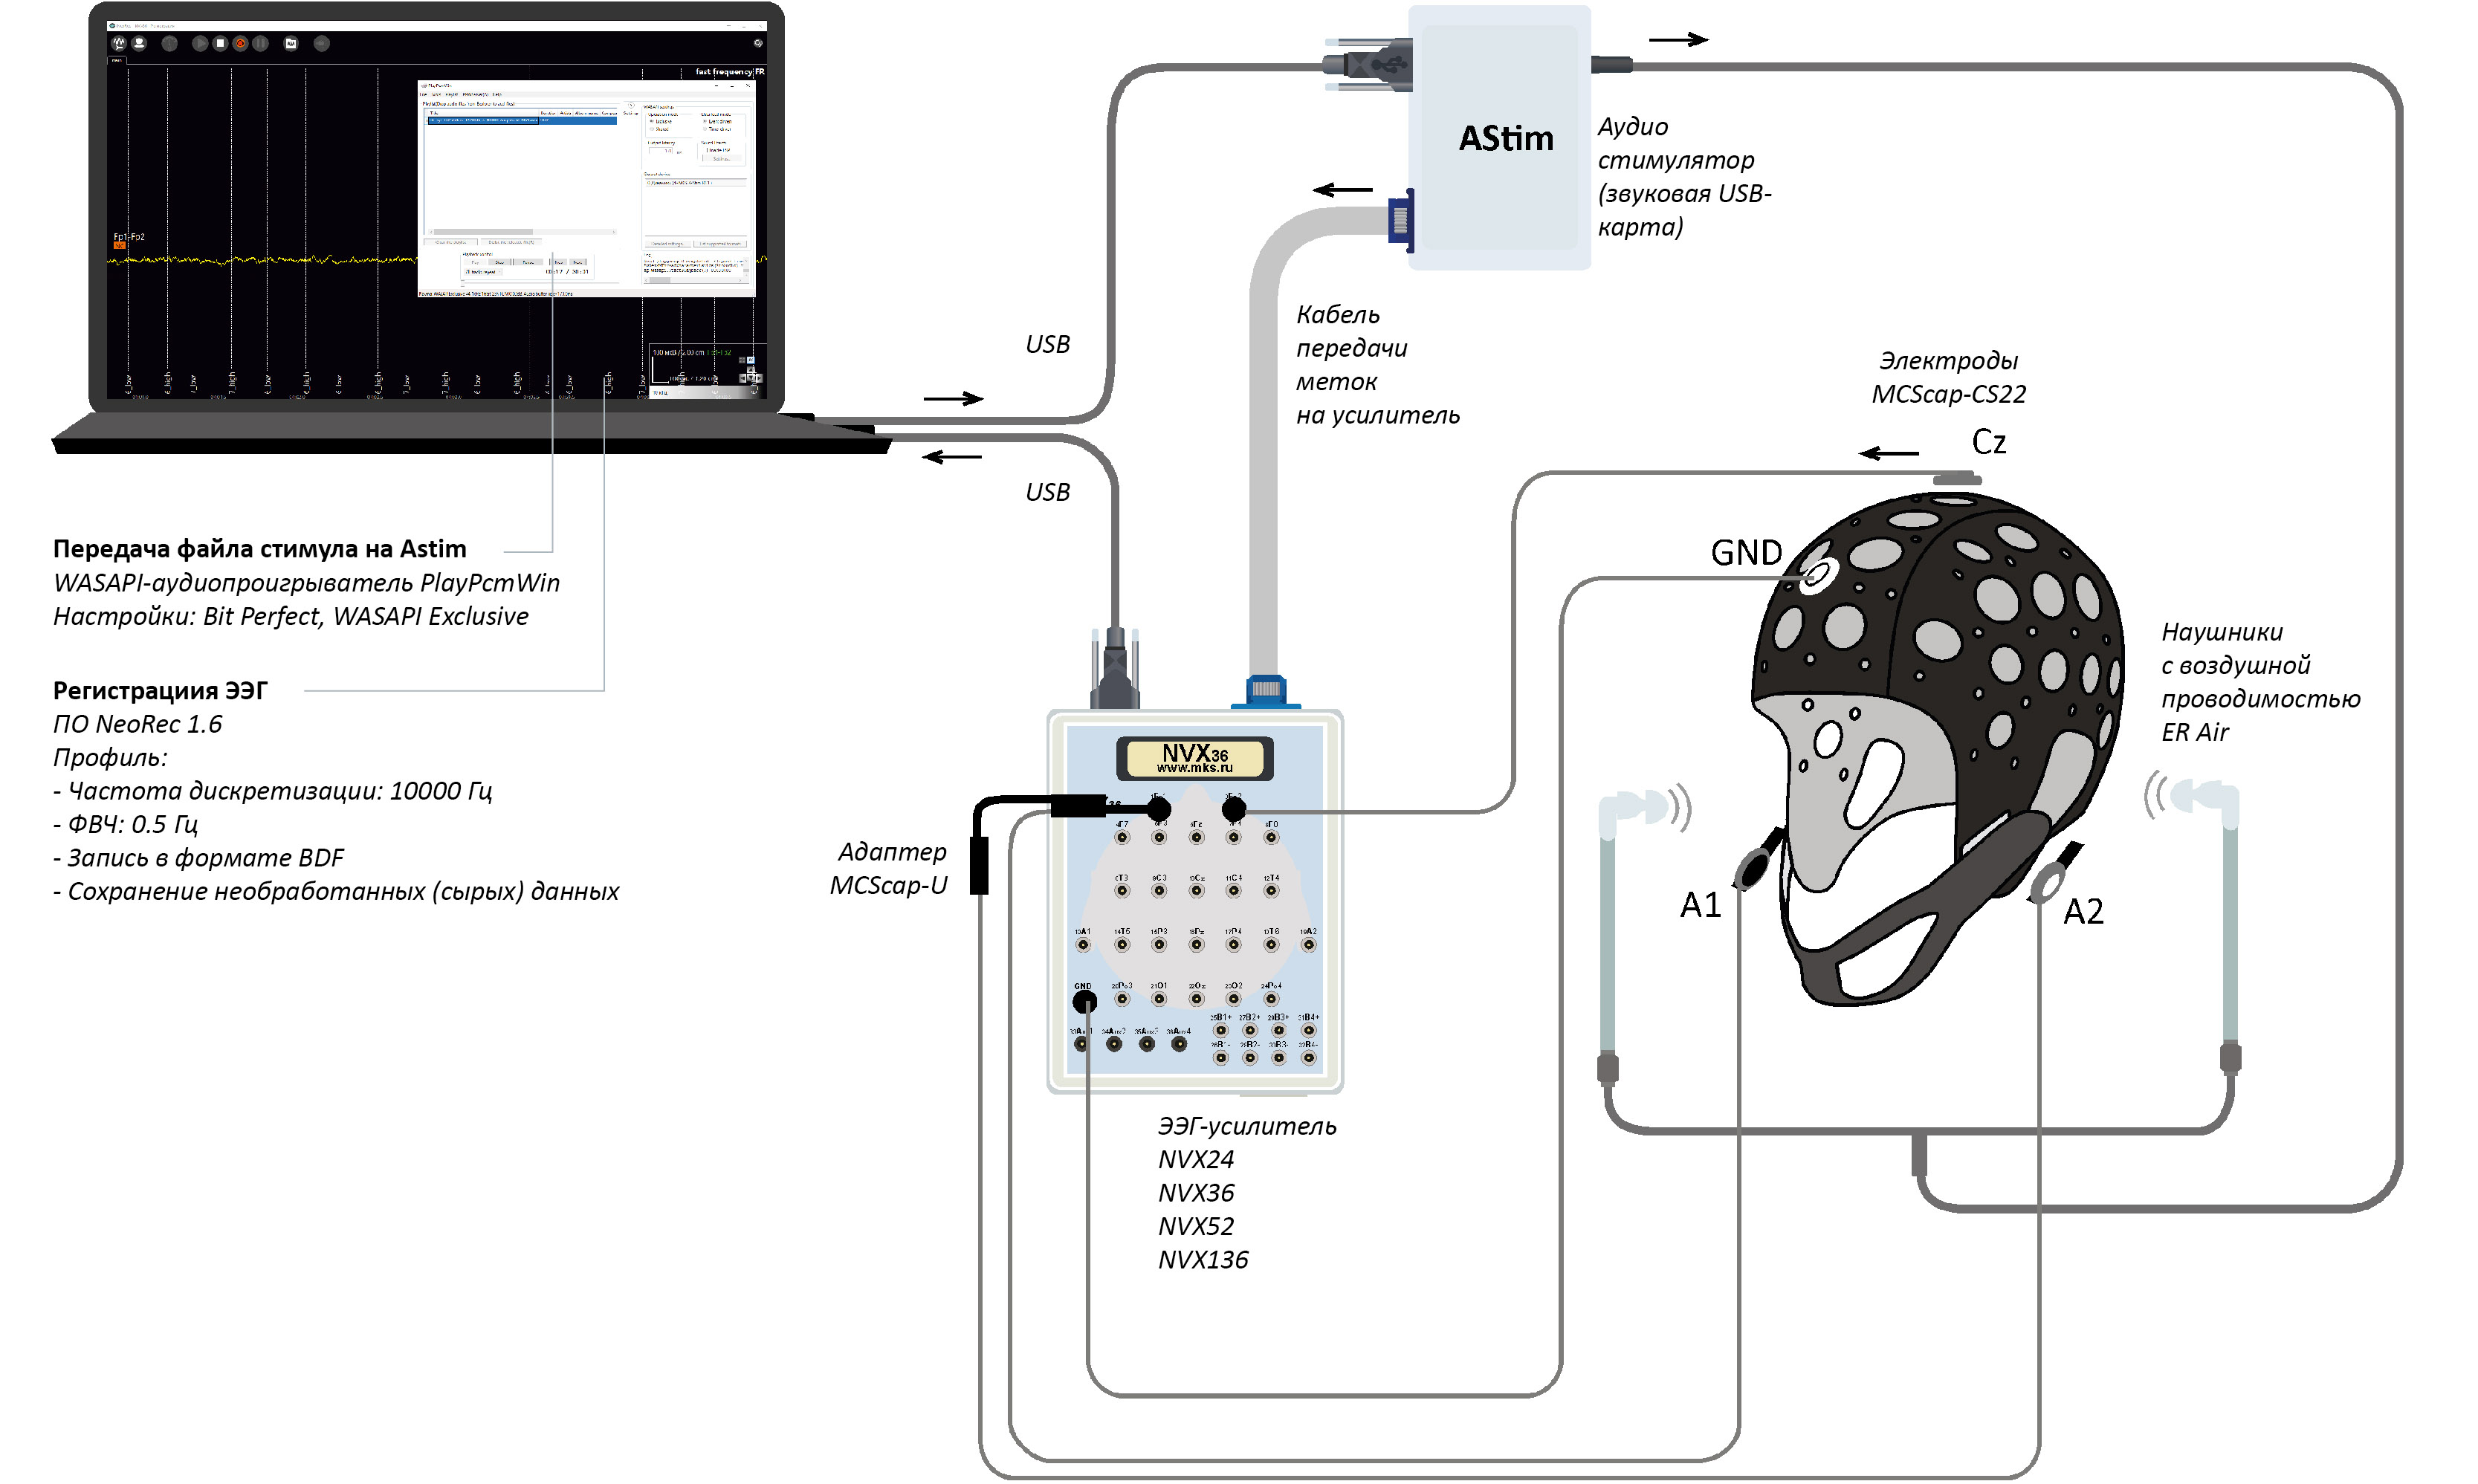
- 1-канальная ЭЭГ-система MCScap с электродами MCScap-CS22 на позициях Cz, GND, Ref (A1 + A2)/2;
- ЭЭГ-усилитель NVX36 или NVX136 (Использовались каналы с высоким разрешением Cz->Fp1, Ref->Fp2, GND->GND);
- предусилитель MNSENS-ACP;
- аудиостимулятор ASTIM;
- акустические наушники Anti-radiation 3.5mm Air Acoustic Tube Earpiece Headset;
- гельтек Унимакс.
ПО
- NeoRec 1.6;
- project FFR (Frequency_Following_Response_Astim Version 1);
- проигрыватель PlayPcmWin (64 бит).
ОБОРУДОВАНИЕ И ПО
ОПИСАНИЕ ЭКСПЕРИМЕНТА
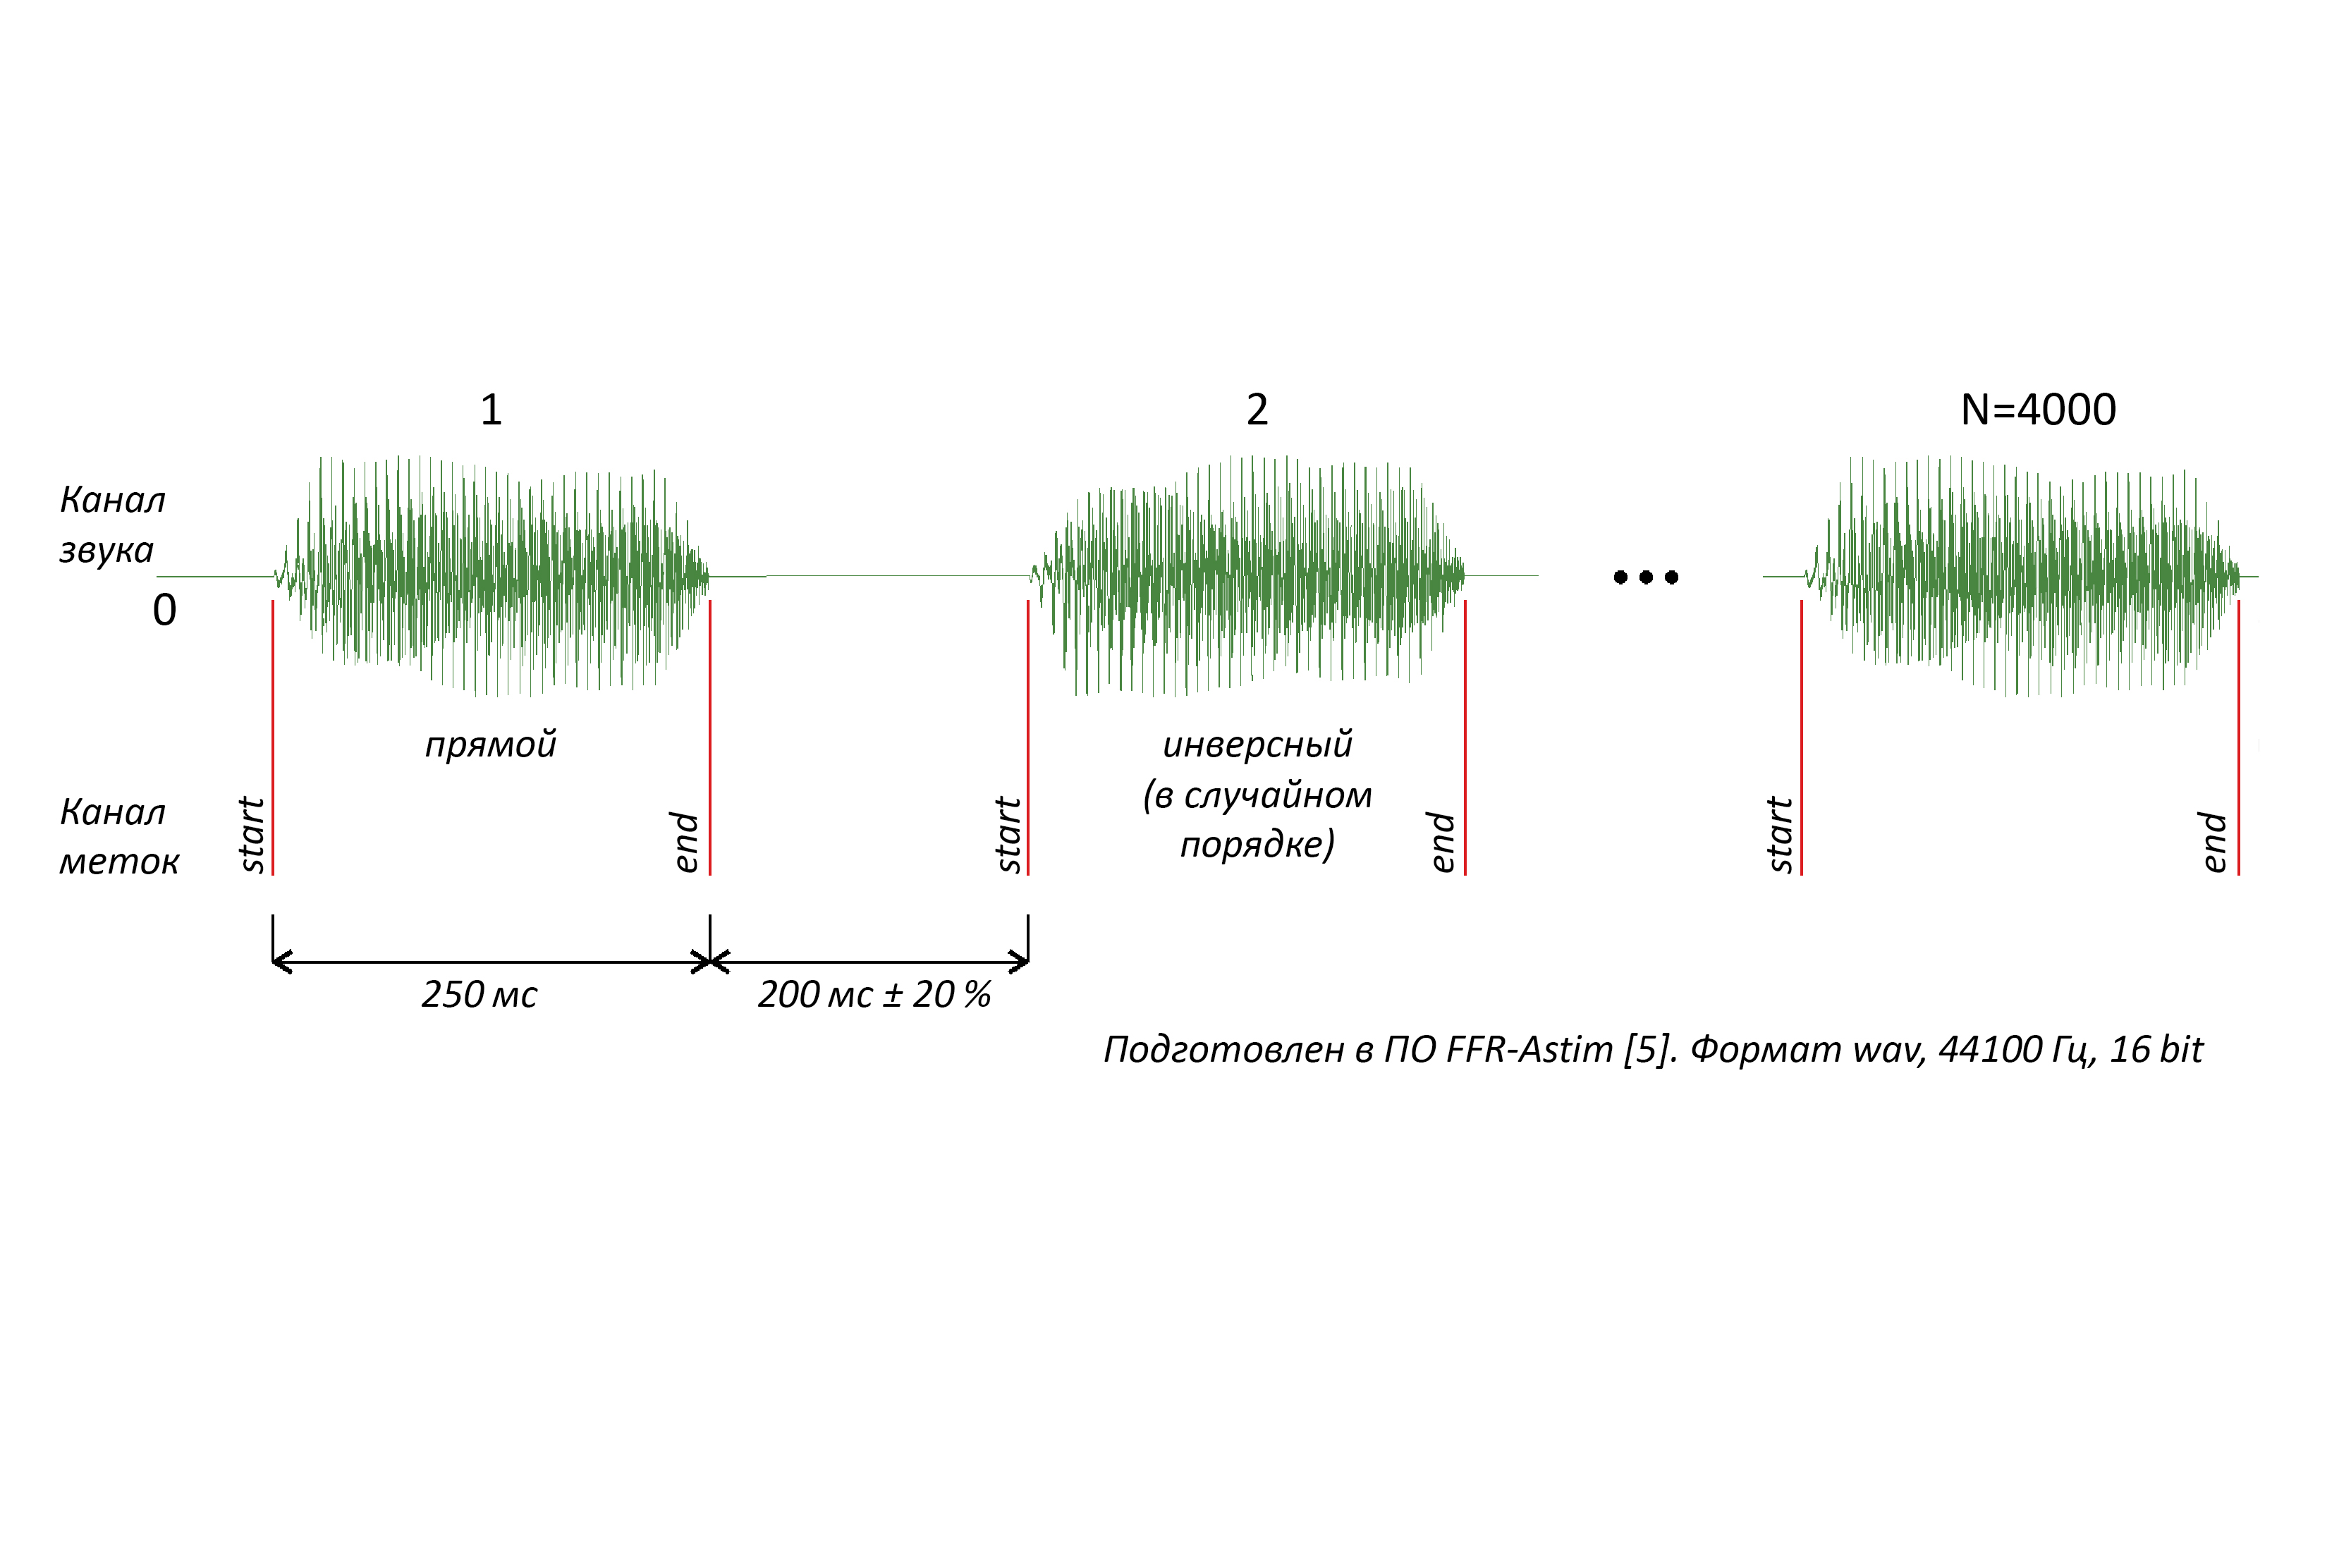
Аудиофайл был создан ПО Project FFR в формате .wav c выделенным каналом для передачи меток. Для устранения костных артефактов использовались стимулы двух типов – оригинальные (6 low) и инвертированные по амплитуде (7 low) [3]. Аудиофайл представляет собой 4000 повторений слога «Да» (2000 повторений оригинального стимула, 2000 повторений инвертированного), разделенных паузами. Длительность стимула 250 мс, длительность межстимульных интервалов 200 мc ±10 %. Стимул подавался на ASTIM в режиме побитовой передачи (Bit-Perfect) WASAPI Exclusive с полным захватом звуковой карты при использовании проигрывателя PlayPcmWin (64-bit).
Буферизация (output latency) проигрывателя составила 170 мс. Задержка проведения звука по трубкам наушников составила 0.7 мс. На предварительных этапах эксперимента уровень шумового давления SPL при проигрывании аудиостимула составлял 78 dB.
Испытуемый свободно располагался в кресле в полутемном помещении, расслаблен, глаза открыты. Допускалось чтение с телефона или ноутбука [4]. Длительность эксперимента – 32 минуты.
Один электрод был размещен в локации Cz, один – GND, референт – (A1 + A2)/2 (на мочках ушей). Значение импеданса на канале Сz составило 13 kOm.
ЭЭГ регистрировали с частотой дискретизации 10000 Гц, При регистрации ЭЭГ использовался предусилитель MNSENS-ACP c коэфициентом усиления Gain 500 и фильтрацией 16–3000 Гц и усилитель NVX36.
Во время эксперимента применили фильтр высоких частот для подавления сигнала ниже 0.5 Гц. Данные сохранены в формате .bdf и в формате необработанных (сырых) данных.
ОБРАБОТКА ДАННЫХ
Для подготовки аудиостимула, обработки сигнала и анализа данных было разработано специальное ПО Project FFR (Frequency_Following_Response_Astim) на языке python [5].
Подготовка. WAV файла для стимуляции
- импорт эталонного стимула;
- создание инвертированного по амплитуде стимула;
- создание во втором звуковом канале меток начала и конца стимула с указанием прямого или инвертированного стимула;
- создание записи из равного количества прямых и инвертированных символов включенных в случайном порядке, разделенных паузами случайной длины 200 мc ±10 %.
Очистка сырых данных
- Проверка совпадения меток в WAV-файле стимула и на ЭЭГ;
- фильтрация 80 – 1500 Гц, Баттерворт 2-го порядка [3], [2];
- сегментация от –100 мс до подачи стимула до 300 мс после подачи стимула;
- удаление артефактных эпох с амплитудами сигнала >40 мкВ [1];
- усреднение по всем безартефактным эпохам относительно начала подачи стимула.
Анализ
- Спектральная амплитуда рассчитывается методом преобразования Фурье (Уэлча) [4] с параметрами: n_fft = 1024, n_per_seg = 1024, n_overlap = 512 (50 % перекрытия). При частоте дискретизации fs = 10000 Гц это обеспечивает частотное разрешение Δf≈9,77 Гц;
- Пиковые спектральные амплитуды и частоты для визуализации определялись на основе 10–12 пиков стимульного файла/данных, отстоящих не ближе, чем на 30 Гц, друг от друга. Из данных пиков выбираются частоты стимула и FFR с коридором ± 10 Гц (до 20 Гц дистанции от пика стимула до пика ответа);
- Коэффициент корреляции Пирсона между стимулом и ответом в интервале формантного перехода [3] определялся на разном числе усреднений (начиная со 100 и далее с шагом 500). При расчёте учитывался лаг 7–10 мс относительно стимула, как время транзита сигнала по слуховым путям [1];
- Соотношение сигнал-шум SNR в интервале форматного перехода также определялся на разном числе усреднений. RMS_signal рассчитывали на интервале interval_signal 19.5–44.2 мс [3] по формуле RMS_signal = (sum(interval_signal ** 2) / len(interval_signal)) ** 0.5. RMS_noise рассчитывали на интервале от –30 мс до 0 относительно начала подачи стимула: RMS_noise = (sum(interval_noise ** 2) / len(interval_noise)) ** 0.5. SNR считали как SNR = RMS_signal / RMS_noise.
НАШЕ ОБОРУДОВАНИЕ
ССЫЛКИ
[1] Coffey EBJ, Arseneau-Bruneau I, Zhang X, Baillet S, Zatorre RJ. Oscillatory Entrainment of the Frequency-following Response in Auditory Cortical and Subcortical Structures. J Neurosci. 2021 May 5;41(18):4073-4087. doi: 10.1523/JNEUROSCI.2313-20.2021.
[2] Gnanateja GN, Rupp K, Llanos F, Remick M, Pernia M, Sadagopan S, Teichert T, Abel TJ, Chandrasekaran B. Frequency-Following Responses to Speech Sounds Are Highly Conserved across Species and Contain Cortical Contributions. eNeuro. 2021 Dec 23;8(6):ENEURO.0451-21.2021. doi: 10.1523/ENEURO.0451-21.202.
[3] Krizman J, Kraus N. Analyzing the FFR: A tutorial for decoding the richness of auditory function. Hear Res. 2019 Oct;382:107779. doi: 10.1016/j.heares.2019.107779.
[4] Skoe E, Kraus N. Auditory brain stem response to complex sounds: a tutorial. Ear Hear. 2010 Jun;31(3):302-24. doi: 10.1097/AUD.0b013e3181cdb272.
[5] ПО Frequency_Following_Response_Astim Version 1. Репозиторий проекта: https://github.com/asmyasikova83/Frequency_Following_Response_Astim